Patologia Computazionale
Estende la Patologia Digitale all’analisi automatizzata delle immagini tramite algoritmi e intelligenza artificiale, ottenendo dal tessuto informazioni più profonde di quelle acquisibili a occhio nudo. Il fine è supportare il patologo nella diagnosi (finora «il miglior computer è ancora il cervello umano»).
Analisi automatizzata per la profilazione molecolare
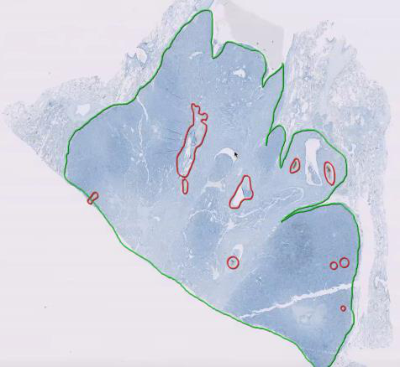
Per una profilazione molecolare il patologo deve cerchiare sulla sezione le zone da analizzare (macrodissezione) e stimare in percentuale la componente neoplastica rispetto alla non neoplastica. La cellularità è cruciale per l’adeguatezza del materiale: un campione al 90% dà accuratezza ben diversa da uno al 5%. Fatto manualmente, ciò introduce variabilità inter-operatore; sistemi di analisi d’immagine che contano le cellule positive per un marcatore danno valutazioni molto più precise.
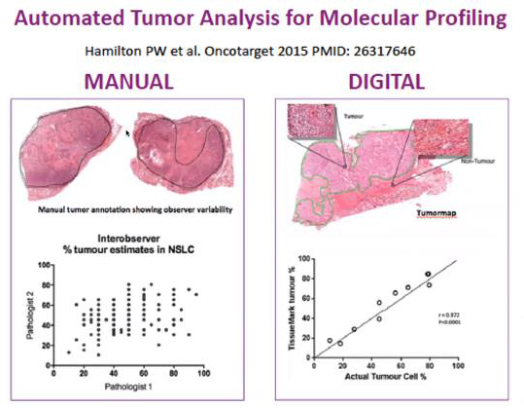
Image-driven automated laser dissection
Un sistema laser ritaglia l’esatta area tissutale da analizzare. Si usano vetrini con membrane (telai) su cui poggia la sezione; al microscopio, con penna elettronica, si tracciano i contorni lungo cui corre il laser. La porzione tagliata cade in provette Eppendorf con soluzione di lisi, avviando automaticamente l’analisi molecolare. Il processo è automatizzabile (area X → pipetta 1, area Y → pipetta 2…), liberando tempo al patologo.
Data mining e floaters
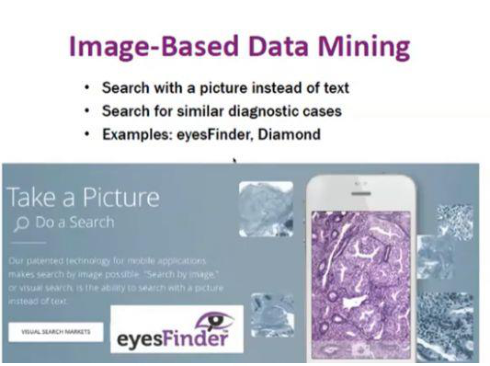
Il data mining (“scavare i dati”) usa le informazioni di un preparato per generare algoritmi diagnostici o ritrovare un caso specifico tra molti simili. Sulle immagini la ricerca è più complessa che sul testo (CTRL-F): si imposta un dettaglio anatomico e il computer trova le immagini con le stesse caratteristiche (analogo alle app che riconoscono le foglie).
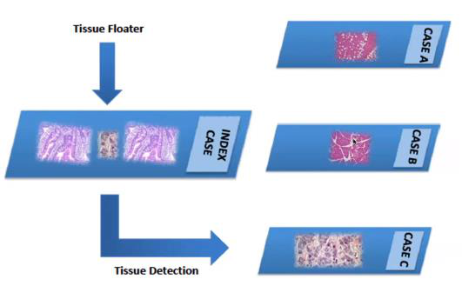
Applicazione: identificare i floaters (contaminazioni, “trasporti”) — frammenti che, nella processazione batched, si distaccano e si attaccano ad altri campioni. Per capire se un floater appartenga al paziente:
- Root cause analysis — ri-analizzare tutte le lesioni simili della giornata (time-consuming);
- tagli più profondi — i componenti tissutali persistono in profondità, i floaters no (time-consuming, non sempre risolutivo);
- analisi molecolari — es. FISH per il cromosoma Y (un floater con Y in una paziente donna è identificato come tale) → vedi FISH.
I programmi di patologia digitale confrontano il floater con l’archivio in pochi minuti, riducendo l’errore (il computer è più ripetibile dell’occhio umano).
Studio IMMINENT (machine learning)
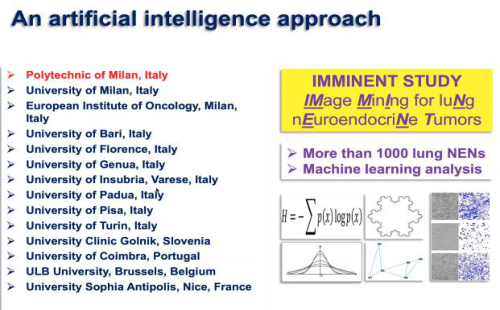
Studio del professore su tumori neuroendocrini polmonari (Image MinIng for luNg nEuroendocriNe Tumors): 1000 casi, algoritmi di machine learning a partire dalla distribuzione dell’antigene Ki-67, che ha distribuzione “bizzarra” con aree colorate (hotspot) e meno colorate (cold-spot). Il conteggio manuale negli hotspot soffre di variabilità inter-operatore ed è una stima puntuale assunta come rappresentativa dell’intero tumore.
Obiettivo: addestrare il computer a riconoscere quali distribuzioni di Ki-67 si associano a buona o cattiva prognosi (distinguendo nuclei positivi marroni in IHC da negativi blu in E-E). Lo strumento ragiona per punti, non per nuclei, quindi può sbagliare (un nucleo grosso = due punti), ma si tratta di errore sistematico — minimizzato analizzando milioni di cellule (analogia kantiana: se la percezione del fenomeno ha un errore sempre uguale, i dati restano utili).
Con il Politecnico di Milano (statistica spaziale, teoria dei grafi, analisi dei frattali, entropia di Shannon) da >620 parametri ne sono stati selezionati ~15, applicati a 30 neoplasie (14 carcinoidi tipici, 10 atipici, 6 a grandi cellule). In 5 gruppi da 6, i primi 4 (24 tumori) sono serviti all’apprendimento (vivi/morti); accuratezza finale 84,3%, in crescita aumentando casi e parametri.
Limite: la quantità di informazioni di follow-up. I carcinoidi atipici esprimono malignità anche dopo molti anni: i tumori neuroendocrini richiedono follow-up di almeno 10 anni (meglio 15–20), quindi casistiche di 20 anni prima.
🔗 Collegamenti
- Patologia Digitale — ⬆️ contesto generale
- Flusso di Lavoro Digitale — ⬆️ fase di analisi dell’immagine
- FISH — 🔬 identificazione molecolare dei floaters (cromosoma Y)
- Immunoistochimica — 🔗 quantificazione di marcatori (Ki-67)